Mixture of Experts — så gör tekniken Mistral snabbare och billigare
Mixture of Experts — så gör tekniken Mistral snabbare och billigare
Det finns ett knep i moderna AI-modeller som nästan ingen pratar om utanför utvecklarkretsar, men som avgör vad ni betalar varje gång ni ställer en fråga. Det heter Mixture of Experts, och franska Mistral AI var först med att göra tekniken populär. I dag används den i nästan alla stora AI-modeller — här är vad den gör, och varför den spelar roll för ett mindre företag.
Först: vad är Mistral AI?
Mistral AI är ett franskt AI-bolag, grundat i Paris 2023 av forskare som tidigare jobbat på Google DeepMind och Meta. De är Europas tydligaste svar på OpenAI och Google, och har blivit kända för två saker.
Det första är Le Chat — deras chattjänst, gratis att använda och en direkt motsvarighet till ChatGPT. Vi lät den tävla mot fyra konkurrenter på en riktig arbetsuppgift i vår jämförelse av AI-chatbottar, och den vann. Svaret kom på under en sekund.
Det andra är att Mistral släpper många av sina modeller fritt. Vem som helst får ladda ner dem och köra dem på egen hårdvara, utan abonnemang. För ett svenskt företag som hanterar personuppgifter är det en poäng i sig: kör ni modellen själva, eller hos en europeisk leverantör, lämnar er data aldrig EU. Vi har gått igenom hela den världen i open source LLM 2026.
Men det mest intressanta med Mistral är hur modellerna är byggda inuti.
Vad är Mixture of Experts?
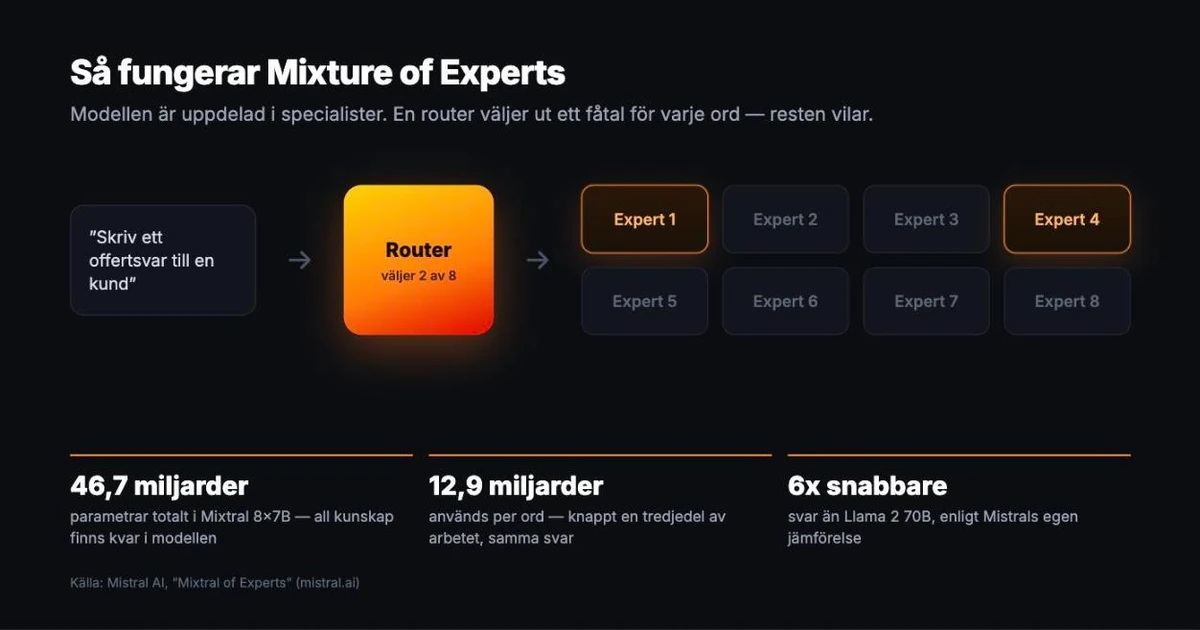
Mixture of Experts betyder att AI-modellen är uppdelad i ett antal specialister, och att bara ett par av dem är igång för varje ord som skrivs. Resten vilar.
Tänk på en konsultfirma med åtta anställda. I den gamla sortens AI-modell läser alla åtta varje mejl som kommer in, funderar, och lämnar varsitt bidrag till svaret. Det blir bra — men det kostar åtta personers arbetstid för varje enda mejl.
I en Mixture of Experts-modell sitter det i stället någon i receptionen. Hon läser frågan, ser att den handlar om avtal och skickar den vidare till de två som kan just avtal. De andra sex fortsätter med sitt. Firman har kvar all sin kunskap — men notan för det där mejlet blev en fjärdedel så stor.
Receptionisten kallas router och är en liten sorteringsfunktion inuti modellen. Ingen har talat om för den vilken expert som kan vad. Den har listat ut det på egen hand under träningen.
Siffrorna bakom: Mistrals Mixtral 8x7B
Mistrals modell Mixtral 8x7B är det tydligaste exemplet, och används fortfarande som skolboksfall när tekniken ska förklaras.
Modellen har åtta experter och 46,7 miljarder parametrar totalt. Parametrar är helt enkelt alla små inställningar modellen justerat fram under träningen — ju fler, desto mer kan den. Men för varje ord den skriver kopplas bara två experter in, vilket motsvarar 12,9 miljarder parametrar. Knappt en tredjedel av arbetet, utan att någon kunskap försvinner.
Resultatet, enligt Mistrals egna mätningar: modellen svarar ungefär sex gånger snabbare än Metas Llama 2 70B, en modell i samma klass, och ger ändå minst lika bra svar. Licensen är dessutom fri — vem som helst får ladda ner modellen, ändra i den och använda den kommersiellt.
Fyra fördelar med Mixture of Experts
- Ni betalar för en bråkdel av arbetet. Priset på ett AI-svar följer i praktiken hur mycket räknekraft som går åt. Kopplas en tredjedel av modellen in i stället för hela, sjunker kostnaden i motsvarande grad. Kör ni tusen fakturasammanfattningar i månaden är det där skillnaden syns på riktigt.
- Svaren kommer snabbare. En chatbot på hemsidan som svarar på två sekunder används. En som svarar på tolv gör det inte. Väntetid är den vanligaste anledningen till att ett AI-verktyg tyst slutar användas på ett kontor.
- Modellerna kan bli större utan att bli dyrare. Ska en vanlig modell kunna mer måste allt bli tyngre. Med Mixture of Experts lägger man i stället till fler specialister — kunskapen växer, men arbetet per ord står stilla. Det är därför nästan alla stora modeller i dag är byggda så här, DeepSeek och Qwen inkluderade.
- Det blir realistiskt att köra en egen modell. En modell som bara använder en tredjedel av sig själv åt gången kräver rimlig hårdvara. Det är skillnaden mellan "vi skulle behöva ett serverrum" och "det går på en hyrd server i Frankfurt".
Varför nästan alla modeller bygger så här nu
När Mistral släppte Mixtral i slutet av 2023 var det ovanligt att göra så här öppet. I dag är det snarare regel än undantag bland de största modellerna.
Kinesiska DeepSeek tog tekniken längst: deras stora modell har omkring 671 miljarder parametrar totalt, men använder bara runt 37 miljarder per ord. Det är ungefär en tjugondel. Det är en stor del av förklaringen till varför DeepSeek kunde erbjuda svar i toppklass till en bråkdel av vad de amerikanska modellerna kostade — och varför priserna på AI föll så snabbt under 2025. Alibabas Qwen och Metas Llama har gått samma väg.
Även GPT-4 rapporterades redan tidigt vara byggd på samma princip, även om OpenAI aldrig bekräftat det. Ingen av de stora leverantörerna berättar längre exakt hur deras modeller ser ut inuti, men prisutvecklingen talar sitt tydliga språk: AI har blivit dramatiskt billigare per fråga, och Mixture of Experts är en av huvudorsakerna.
Haken: en sak löser tekniken inte
Minnet. Även om bara två experter arbetar måste alla åtta ligga framme, redo att kallas in. Modellen räknar alltså som en liten modell men tar plats som en stor.
I praktiken betyder det att Mixtral 8x7B är snabb, men ändå för tung för en vanlig kontorsdator. Ni behöver en maskin med rejält med minne, eller en hyrd server. Snabbheten är gratis. Utrymmet är det inte.
Det är också värt att veta att fördelen är störst när många frågor ska besvaras. Ska ni ställa tio frågor om dagen spelar det ingen roll vilken teknik som sitter under huven — då är det enklare och billigare att betala för ett vanligt abonnemang.
Mistral eller ChatGPT — vad passar er?
Det korta svaret: det beror på vad ni ska göra.
- Skriva text, sammanfatta möten, bolla idéer. Stanna i ChatGPT eller Claude. Ekosystemet är bredare, och för några användare i månaden är prisskillnaden inte värd besväret.
- Många frågor, samma sorts uppgift, varje dag. Räkna på Mistral. Det är i volym Mixture of Experts betalar sig.
- Datan får inte lämna EU. Då är Mistral ofta det enklaste svaret: europeiskt bolag, servrar i Europa och modeller ni får ladda ner och köra själva.
- Vill bara testa. Le Chat är gratis på chat.mistral.ai. Ställ samma fråga där som i ChatGPT och jämför — det tar fem minuter.
Så testar ni på en kvart
Ni behöver varken utvecklare eller budget för att bilda er en uppfattning:
- Ta en uppgift ni redan gör ofta. En offertmall, ett svar på en vanlig kundfråga, en sammanfattning av ett mötesprotokoll.
- Kör samma uppgift i Le Chat och i ChatGPT. Klistra in exakt samma text i båda. Ta tid på svaren och jämför kvaliteten själva — inte utifrån en topplista.
- Räkna på volymen. Hur många gånger i månaden skulle ni köra det här om det fungerade? Är svaret "några stycken" räcker ett vanligt abonnemang. Är svaret "hundratals" är det värt att titta närmare på en egen modell.
Vad ska ni ta med er?
Mixture of Experts är ingen marknadsföringsterm utan ett konkret sätt att göra AI billigare att köra. För er som köper AI betyder det tre saker: lägre pris per fråga, kortare väntetid och en realistisk chans att köra modellen på egen mark.
Är begrepp som modell och parametrar fortfarande luddiga går vi igenom grunderna i vad en språkmodell är. Och vill ni ha hjälp att räkna på om en egen modell lönar sig hos just er — och bygga det som ska köra den — gör vi det som AI-konsult.
Vanliga frågor
Vad är Mixture of Experts?
Mixture of Experts (MoE) är ett sätt att bygga AI-modeller där modellen delas upp i flera specialister, och bara ett par av dem används för varje ord som skrivs. En liten sorteringsfunktion som kallas router väljer vilka. Modellen behåller all sin kunskap men utför bara en bråkdel av arbetet, vilket gör svaren både snabbare och billigare.
Vad är Mistral AI?
Mistral AI är ett franskt AI-bolag som grundades i Paris 2023 av forskare från Google DeepMind och Meta. De driver chattjänsten Le Chat, som är gratis att använda, och släpper många av sina språkmodeller fritt så att vem som helst kan ladda ner och köra dem på egen hårdvara. Bolaget är Europas största utmanare till OpenAI och Google.
Hur många parametrar har Mixtral 8x7B?
Mixtral 8x7B har 46,7 miljarder parametrar totalt, men använder bara omkring 12,9 miljarder av dem för varje ord den skriver. Det beror på att modellen har åtta experter och kopplar in två åt gången. Enligt Mistrals egna mätningar ger det ungefär sex gånger snabbare svar än Metas Llama 2 70B.
Är Mistral bättre än ChatGPT?
Inte generellt — det beror på uppgiften. ChatGPT har bredare ekosystem och fler funktioner, medan Mistral är snabbare och billigare per fråga och drivs av ett europeiskt bolag med servrar i EU. I vårt test av fem chatbottar på samma uppgift vann Mistral Le Chat, framför allt på svarstid. Kör ni många frågor av samma typ, eller har krav på att datan stannar i Europa, är Mistral ofta det bättre valet.
Vilka nackdelar har Mixture of Experts?
Den största är minnet. Även om bara två experter arbetar åt gången måste alla ligga inlästa och redo, så modellen räknar som en liten modell men tar plats som en stor. Mixtral 8x7B är därför för tung för en vanlig kontorsdator och kräver en maskin med mycket minne eller en hyrd server. Fördelen syns dessutom först i volym — vid några frågor om dagen märks ingen skillnad.
Kan man använda Mistral gratis?
Ja. Chattjänsten Le Chat är gratis på chat.mistral.ai och finns även som app. Dessutom är flera av Mistrals modeller fritt nedladdningsbara under öppen licens, vilket innebär att du får köra dem på egen hårdvara utan att betala licensavgift — då betalar du bara för datorkraften.